データ基盤、分析、データベース
MySQLの「ST_Touches()」や「ST_Crosses()」などの8つの関数でジオメトリの位置関係を見比べてみよう
はじめに 第25回 ではST_Within()とST_Contains()で「含まれる」関係を、 第26回 ではST_Intersects()で「交わる」関係を判定する方法を紹介しました。実はMySQLには、この手の「2つのジオメトリがどういう位置関係にあるか」を判定する関数がたくさん用意されています。 今回と次回の2回にわけて、まだ紹介していない関数も含めて全部で8つの判定関数を、一気に見比べてみます。個々の関数を見ているだけでは気づきにくい特徴などを浮き上がらせることができればと思います。 舞台は日本へそ公園 サンプルデータは、みんな大好き「北緯35度、東経135度付近」の数値を使うことに
Amazon RDS データベースプレビュー環境で MySQL 26.7 を試してみた
MySQL 26.7 は「年.月」形式の新バージョン体系で登場した最初の Innovation リリースです。9.7 LTS との違い、プレビュー専用エンドポイントでの起動手順、performance_schema で Change Stream Applier の設定カラムを確認した結果と、60日で自動削除されるなどプレビュー環境の制約をまとめます。
Google Cloud、ローカルマシンにインストールできる大規模分散型マルチモデルDB「Spanner Omni」正式版リリースを発表
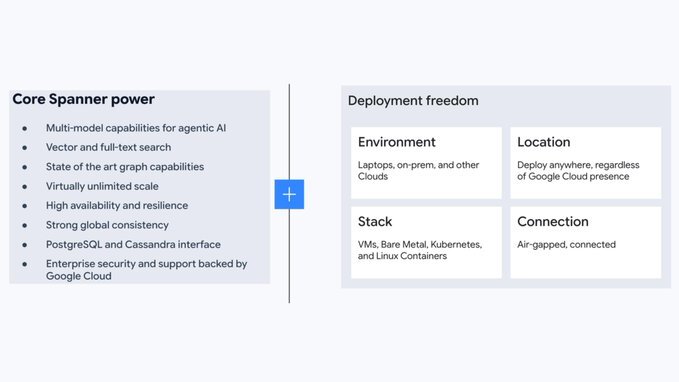
Google Cloudは、大規模分散データベースとしてリレーショナルモデルだけでなくグラフ型やキーバリュー型、ベクトル検索、テキスト検索などのマルチモデルに対応したデータベースソフトウェア「Spanner Omni」の正式版リリースを発表...
Aurora PostgreSQL の新機能「aurora_analytics」で S3・S3 Tables の直接クエリを試してみた
Aurora PostgreSQL 17.11 でサポートされた aurora_analytics 拡張を使い、S3 の Parquet ファイルと S3 Tables の Iceberg テーブルを外部テーブルとして定義し、Aurora の業務データと ETL なしで JOIN できました。

Amazon OpenSearch Ingestion と Amazon RDS および Amazon Aurora の統合
Amazon Aurora および Amazon RDS(MySQL / PostgreSQL)と Amazon OpenSearch Service の統合が一般提供開始されました。Amazon OpenSearch Ingestion を使うと、ETL パイプラインを自前で組まずに、データベースの内容をニアリアルタイムで OpenSearch に同期できます。本記事では、サンプルの HR データベースを使って設定の流れと同期の動きを紹介します。
第134回 MySQL Workbenchの復活、PostgreSQL次期メジャーバージョン19最新情報
この連載はOSSコンソーシアム データベース部会のメンバーがオープンソースデータベースの毎月の出来事をお伝えしています。
Amazon Aurora PostgreSQL がデータレイク上の Apache Iceberg と Parquet データへの直接クエリをサポート
Amazon Aurora PostgreSQL で、データレイクに保存された Apache Iceberg および Apache Parquet 形式のデータを直接クエリできるようになりました。DuckDB が Aurora PostgreSQL に組み込まれ、ETL パイプラインなしで運用データとデータレイクのデータを 1 つのクエリで横断的に分析できます。
【登壇資料】「データ品質を壊しながらSnowflakeのAIに分析させてみた」というタイトルで登壇しました #devio2026
データ品質をぐちゃぐちゃにしながらSnowflakeのAIであるCortexに分析して様子を見てみました。AIは非常に頭が良くて正確なSQLを生成します。しかしデータ自体が悪くなっていれば、その結果に意味なんてないのです。データ品質、だいじ。
Digdag on GKEからManaged Service for Apache Airflowへの移行と監視の紹介
はじめに こんにちは、MA部のMA基盤開発ブロックの@gachi-muchi-engineerと松岡(@pine0619)です。 MA部では、メール、LINE、プッシュ通知などを配信しています。配信に必要なデータの生成や夜間の集計など、複数のワークフローを運用しています。これまで、これらのワークフローはGKE上に構築したDigdagで実行していました。Digdagの構成や運用については、以下のテックブログで紹介しています。 techblog.zozo.com Digdagは、ワークフローを定義して実行するための便利なツールでした。一方で、近年は開発が活発ではなく、利用中に発生した問題や機能不足
【登壇資料】 「Snowflake Horizon Catalog と Apache Iceberg で作る オープンなデータ基盤」 というタイトルでDevelopersIO 2026 Osakaに登壇しました #devio2026
DevelopersIO 2026 Osakaの登壇ブログです。Snowflake Horizon Catalog と Apache Iceberg のことについて話しました。
【SELECT AIの精度が出ない時に試したい5つのポイント】①対象表の絞り込み
はじめに SELECT AIに自然言語で質問すると、SQL自体は生成されるものの、期待とは違うテーブルが使われることがあります。 たとえば「2026年の売上を顧客別に集計して」と質問したとき、データベース内に次のテーブルがあったらどうでしょうか。 受注を管理するORDE...
Kafkaアラートの初動調査を支援するAI Alert Watcherの開発(インターンレポート)
はじめにこんにちは。法政大学情報科学部3年の霍 永豪と申します。2026年8月17日〜9月11日の4週間、社内のデータ基盤に使われているKafkaを運用するチームでインターンとして参加し、Grafan...
KestraとAmazon EKSのキャパシティプランニング - JVMに思いを馳せながら
エムスリーエンジニアリンググループGMで、データエンジニアの木田です。 この記事はデータ基盤チームのブログリレー4日目の記事です。前回は橋口さんの 「BigQueryのスロット、返し忘れていませんか? fluid scalingによるスロット費用最適化」 でした。 データ基盤チームでは Digdag / Embulk で長年運用してきた各種サービスから BigQuery へのデータ連携基盤を、Kestra(OSS のワークフローオーケストレータ)と EKS(AWS のマネージド k8s)へ移行しています。 移行作業自体は現在最終局面といったところで、Kestra の選定経緯や使用感については後
dbt Summit 2026に、dbt Championとして参加してきました
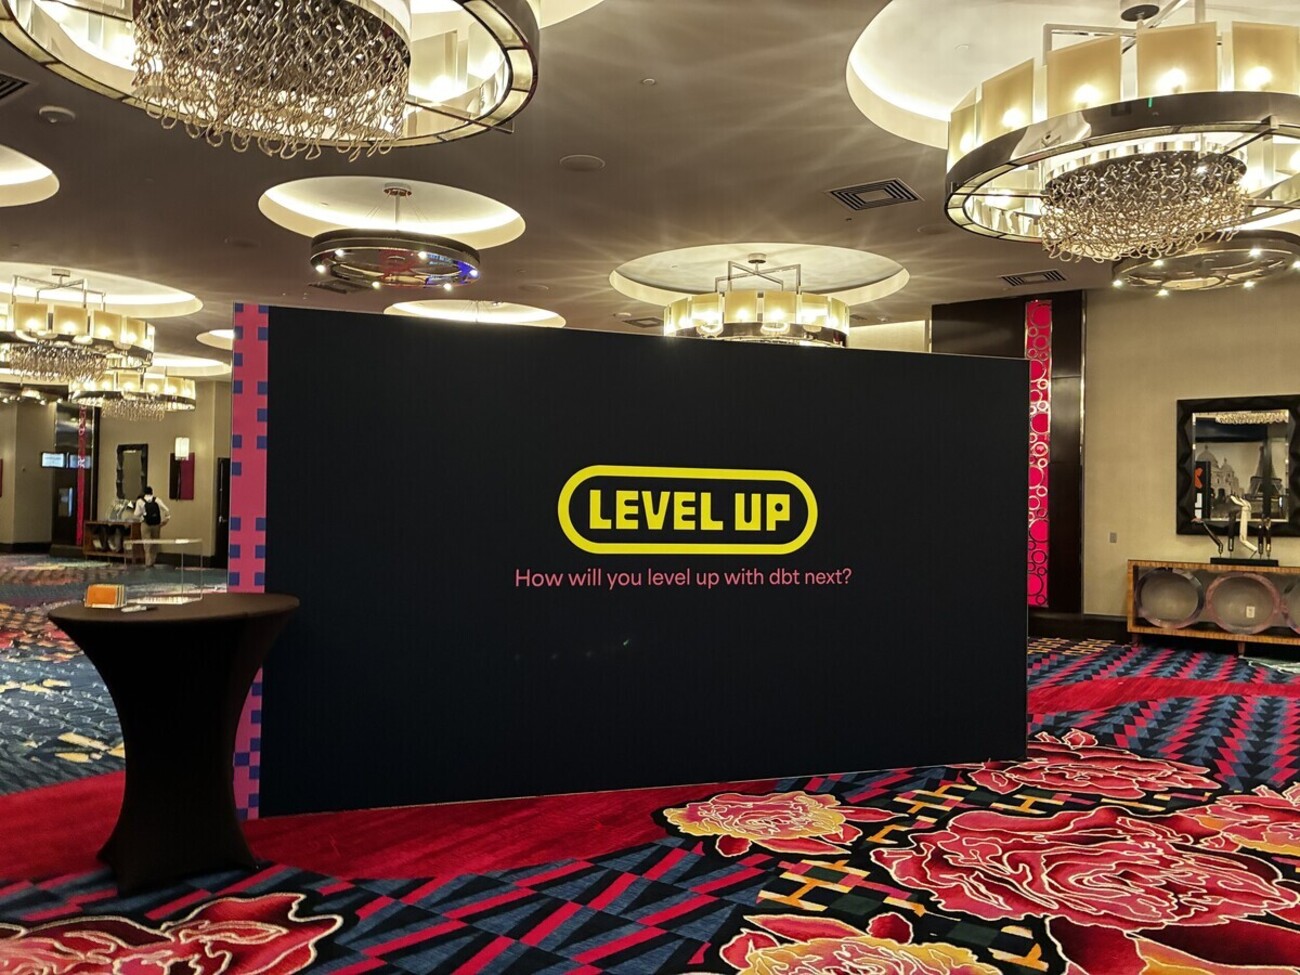
ラスベガスで開かれたdbt Summit 2026(2026年9月15〜18日)の参加レポートです。発表された内容を、10Xで日々dbtやデータに触れる中で考えていることと結びつけながらまとめます。 会場ロビーのLEDボード。「How will you level up with dbt next?」 1. dbt Summitに行くことになった経緯 2. 今年のテーマ「Level Up」 3. 発表されたもの 「2エンジン時代」の終わり 4. コストの話:dbt v2、batch tests、dbt State batch tests unit testをローカルで流す dbt State
DatabricksとSnowflakeどっち?を毎回聞かれるので、機能表じゃない選び方を書く
機能比較表を見ても決められない 業務でDatabricksとSnowflakeの両方を触っています。で、「結局どっち?」を定期的に聞かれます。 機能比較表はもう腐るほどあるんですが、あれを読んで決められた人を見たことがありません。理由ははっきりしていて、2026年時点で機...
[ハンズオン] サクッと AWS CloudShell で dbt v2(dbt-oss)+ DuckDB のビルド・テスト・リネージまで体験する15分ハンズオン!
最新の dbt v2 の DuckDB アダプタが標準搭載されたので、AWS CloudShell で dbt-oss をインストールし、CSV の取り込みからモデルのビルド、テスト、リネージ確認まで、15分で完結するハンズオンを作成しました。
DatastreamのBigQueryコストを92%削減できた取り組み
データシステム部データ基盤ブロックの小泉です。データ基盤ブロックでは、社内のさまざまな業務領域のリレーショナルデータベースを、DatastreamでBigQueryへリアルタイム連携しています。この基盤は各部門が分析やダッシュボード等で活用しており、私たちが横断的に管理しています。多くのチームが参照する基盤はクエリ費用がかさみやすく、かつ各テーブルの更新頻度を利用者側で一元的に把握することも難しいという課題がありました。 本記事では、staleness limit(データの更新頻度)の見直しによるクエリ費用削減の取り組みを紹介します。あわせて、その設定を一度きりで終わらせず、CI/CDによる自
EXPLAIN で詰まったときの三つ目の手札、Optimizer Trace の話
はじめに こんにちは。プラットフォームエンジニアリングチームに所属している徳富(@yannKazu1)です。 MySQL が遅いとき、まず EXPLAIN で計画を見る。見積もりが怪しければ EXPLAIN ANALYZE で実測と突き合わせる。たいていのケースはこの二つで十分で、実際自分もそれで困ったことはほとんどありませんでした。 ところが先日、この二つをいくら眺めても答えが出ない場面に当たりました。最後に頼ったのが Optimizer Trace でした。普段のチューニングではまず使わないので、すっかり引き出しの奥にしまっていた手札です。そこに至るまでの経緯も含めて書いておきます。 まず

「ezpipe」でkintoneからRedshiftに連携する
kintoneからAmazon Redshiftへのデータ連携方法を、ezpipeを使って紹介します。接続元・接続先・パイプラインの3つの設定手順と、実際の連携結果までを順を追って見ていきます。

「なぜ環境を変える必要があるのか」で“きれいごと”は言わない!――「本音」の転職で異業界の最前線へ飛び込むまで - 若者がのぞむ仕事とは何か~わたしが選んだ「会社」と「働き方」
「仕事は順調。でも、自分が介在している実感が湧きづらい」――経営に近いポジションで全体の戦略を描き続ける中で、現場との距離感に悩む人は少なくありません。今回は大手流通ホールディングスでのデータ分析の経験を経て、「手触り感へのこだわり」に向き合い、異業界へ挑戦して納得のキャリアをつかんだ30代男性の事例から、理想の転職を実現するためのヒントを探ります。

AirflowにおけるDAGファイルの定期パースとPythonのimportの話
はじめに 最近「DAG ファイルのトップレベルに必要のない処理を書くな」というAirflowのベストプラクティスを知る機会がありました。 トップレベルのコードがどのように影響するのかをローカルでコンテナ環境を作って検証をしてみると、Pythonのimportの挙動についても理解を深めることができたため、記事に残したいと思います。 検証環境 検証環境は Airflow 3.3.1(apache/airflow:3.3.1)、CeleryExecutor + Postgres 16 +Redis 7.2。公式のdocker-compose.yamlをほぼそのまま使い、サンプルDAGを...
LTVの計算式は、DDLのどこにも書いていない──AIエージェントに「データの意味」を渡すApache Ossie
AIエージェントに社内のデータベースをつなぎ、自然言語で問いかける。この構成はすでに多くの現場で試されているが、テーブル定義(DDL)を渡すだけでは、返ってくる数字が正しいとは限らない。Developers Summit 2026 Summerのセッション「AI Agentは“データの意味”を理解できるか?」で、Snowflakeの田中翔氏は、DDLのみを与えた場合とビジネス定義を与えた場合とで生成されたSQLを比較し、AIが「間違える境界」を具体的に示した。鍵となるのは、Apache Software Foundationのインキュベーターに採用された共通規格Apache Ossieと、セマ
「データベースがアプリごとにバラバラ」を解消、しかも年100万円以上を削減――金融機関はどう実現?
業務システムのデータ分断やコスト負担の増加に直面していた旭川信用金庫。背景には、利用していた開発ツールの仕様があったという。こうした状況から脱却するために、開発ツールをどう見直したのか。

Parquet の仕様にも入った ALP (Adaptive Lossless floating-Point) とは何なのか
Parquet 2.14.0で、ALP という浮動小数点数の圧縮方式が仕様に入りました。以下が公式ブログによる解説です。 https://parquet.apache.org/blog/2026/09/22/alp-adaptive-lossless-floating-point-encoding-in-apache-parquet/ ALP は、DuckDB や LanceDB、Vortex などですでに使われている圧縮方式です。ちなみに、元論文 はオランダの研究者によるものなので、DuckDB とは近いコミュニティなんだと思います。 正直、技術的な詳細はあまり理解できていないのですが...
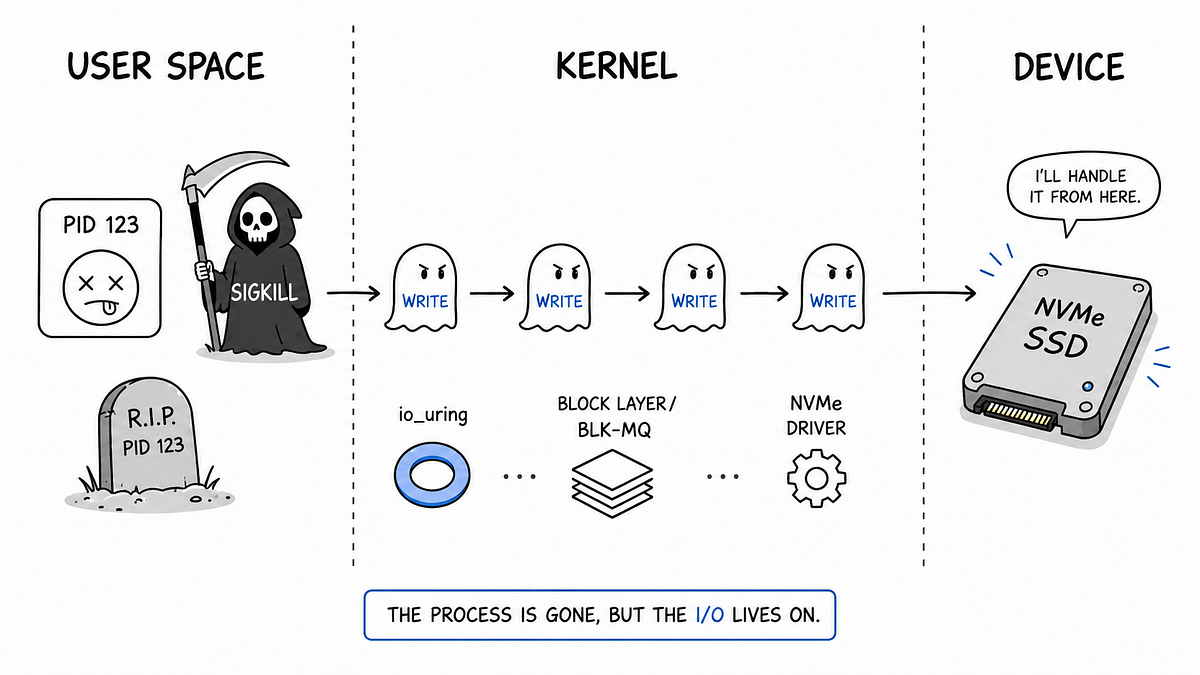
プロセスが終了しても入出力は行われるのか?プロセスが終了するとio_uringはどうなるのか?
一般的なイメージではOSのI/O操作はプロセスが終了すると停止するものと受け止められているのではないでしょうか。しかしながら、LinuxカーネルにおけるI/O操作のライフサイクルは必ずしもプロセスのライフサイクルと一致しないことがあります。特にLinuxカーネル5.1で導入されたio_uringを使用した場合、プロセスが終了した後でもI/O操作がカーネル内で継続しストレージに到達する可能性がデータベースプラットフォーム開発者のエフゲニー・イワノフ氏により報告されています。 続きを読む...

最近話題のJevはBigQueryのAI関数を安くできるのか?
こんにちは。メガベンチャーでデータアナリストとして3年弱働き、今年の初めにデータエンジニアへ異動したじゃっこです🔰……なんともう3四半期が経ちそうです。そろそろドメイン知識不足を言い訳にできなくなってきました😭 最近、にわかにJevが流行っています。 https://typesafe.ai/ Jevは、長い文章を生成するためではなく、選択肢から一つを選ぶ、数値を付ける、といった意思決定に特化した小さなモデルです。Vercel AI Gatewayからも利用でき、入力$0.04 / 100万token、2026年9月25日までは出力無料。大量の分類やルーティングに向いていそうです。 データ.